大家好,这里是AI4ELAB,我是秦明。今天一大早,一位在谷歌做AI工程师的朋友给我转来一条帖子,源头作者AI大神Karpathy,OpenAI的创始成员、前特斯拉AI负责人Andrej Karpathy。帖子发出一天,浏览量超过230万。我在硅谷一线的朋友也直呼,前沿AI的进化非常可怕。


Karpathy的判断是,人们对大模型能力的认知差距在变大,全球只有大约5000号人接触到前沿级AI系统。这条帖子是他把今年4月的一条旧帖翻出来重新展开。

4月那条讲的是「两拨人各说各话」。
第一拨人去年试过免费版ChatGPT,就拿那次印象给AI下结论,热衷于嘲笑模型的幻觉和低级错误。Karpathy说,这些免费的、老旧的模型,代表不了今年最新的智能体模型,比如OpenAI的Codex和Claude Code。
就算每月付200美元用上最好的模型,进步也集中在高度技术化的领域。搜索、写作、咨询这类日常用法,进步并不明显:一部分是技术原因,另一部分是这些用法赚不到多少钱,厂商没有优先优化。
第二拨人既付费用最前沿的智能体模型,又在编程、数学、研究这类技术领域里专业地用。他们看到模型能把原本要几天到几周的编程问题化掉,于是把AI的能力和后果看得重得多。他形容这群人最容易陷入「AI精神错乱」。
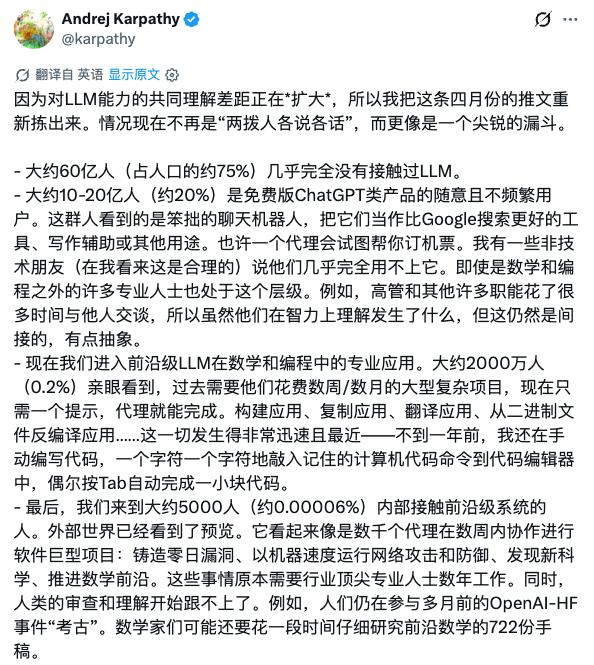
半年过去,他改口了:现在更像一个越往下越窄的漏斗。他给了一组自己粗算的数字。
最上面一层约60亿人,占全球人口的75%左右,基本没接触过大语言模型。
第二层10到20亿人,约20%,偶尔用免费版的聊天产品,把它当成更好用的搜索、写作助手。他说,数学和代码以外的很多专业人士也在这一层,比如高管,大部分时间在和人打交道,道理上明白AI在发生什么,体验却是二手的。
第三层约2000万人,约0.2%,在数学和代码领域专业地使用最前沿的模型。他们亲眼看到,过去要几周甚至几个月的大项目,现在给智能体一段提示就能做完。Karpathy说,不到一年前,他自己还在编辑器里一个字符一个字符地敲代码。
最底下一层大约5000人,只占0.00006%,能用到实验室内部的前沿系统。外界只看到过一点预告:几千个智能体连续几周协作完成超大型软件项目,以机器的速度做网络攻防,做出新的科学发现,推进数学前沿。人类的审查和理解已经开始跟不上。
读完我问朋友,你在那5000人里吗?他说不在,自己属于那0.2%,但已经感受到了变化。
漏斗为什么会存在,Karpathy给了三个原因。
第一,影响力随问题的规模放大。一段话就能回答的问题,体现不出系统的本事;手里得有一堆真正在乎的大难题,才看得到差距。这决定了普通用户和专业用户之间的那道缝。
第二,能力分布不均。模型的能力集中在数字化、结果可以验证、经济价值高的领域,因为它的能力来自在可验证的奖励上做强化学习,而训练环境的选择又跟着收入潜力走。这解释了为什么最先被改变的是数学和代码。
第三,使用权限。免费版、付费版和实验室内部版,用的根本不是同一个东西。
他的结论是,这个时刻的怪异之处在于几种体验同时存在:大众基本没碰过;碰过的看到一个笨笨的聊天机器人;多数专业人士只感到小幅提升;极少数人正在经历曲线陡然竖起来的眩晕。
放到工程行业,大多数人落在第二层。设计、施工、造价的日常工作,很多时间花在开会、打电话、协调上,正是他说的「数学和代码以外的专业人士」。
但他给的第二个原因也指出了缝隙在哪:结果能验证的环节会先被改变。工程里有不少这样的环节,比如规范检查、算量、图纸比对。
对第二层的人来说,最容易犯的错,是拿自己见过的那个笨笨的聊天机器人,去判断第三层正在发生什么。
资料来源
本文为 AI4ELAB 编辑或原创,作者:Connor 秦明。转载请注明出处:https://ai4elab.com/9692.html


